poradnik
Zaktualizowałem firmowy mózg AI dla całej firmy - jak to zbudować?
Igor Pielas ·
Wiedza w firmie zawsze rozjeżdża się po różnych miejscach, dezaktualizuje, bywa pisana w formacie który ludzie ogarniają, ale agent już nie. Opisuję jak zbudowałem warstwę wiedzy firmy działającą zarówno dla zespołu, jak i dla agentów. Po co to jest, dlaczego ma sens, jak to zbudowane i jak Ty możesz zrobić to samo w swojej firmie.
Kilkanaście godzin pracy z Claude Opus 4.7 i mój zespół Activy (głównie operacje Customer Success i Sales) ma od dziś nowy, lepszy "mózg" - bazę wiedzy podpiętą pod Claude przez Cowork. Ustrukturyzowaną, jakościową, zawsze aktualną i z mechanizmem samoistnego poprawiania. Nazwałem to "Activy Brain" i ten artykuł jest o tym, po co to powstało, dlaczego było potrzebne, jak to zbudowałem i jak Ty możesz zrobić coś podobnego u siebie.
Po co to w ogóle jest, czyli odwieczny problem każdej firmy
Wiedza w firmie zawsze jest ciężka do wprowadzenia. Trzeba sobie powiedzieć szczerze, że w żadnej firmie nie jest tak, że wiedza po prostu jest, dostępna, aktualna, w jednym miejscu. Zawsze jest porozrzucana po różnych miejscach: trochę artykułów w Notion, trochę plików w Drive, trochę w Slacku, trochę w głowach ludzi, trochę zaszytych w agendach spotkań, trochę w nagraniach, których nikt nie odsłuchał drugi raz. Wszystko się dezaktualizuje, każdy zespół ma swoje osobne miejsca i własne konwencje, i jak nowa osoba przychodzi, to przez pierwsze tygodnie po prostu pyta resztę zespołu o rzeczy, które dawno powinny być spisane.
Co gorsza - i to dochodzi w erze AI - sporo z tego co mamy spisane jest napisane w formacie i języku dla człowieka, czyli długie wpisy, dziwne formatowanie, fragmenty list bez kontekstu, szablony z miesięcznych spotkań, w których kluczowe decyzje są ukryte gdzieś pod punktem 14. Człowiek to ogarnie, jak będzie miał dwie godziny i kawę. Agent natomiast wczyta to i albo zhalucynuje, albo zwróci coś bezużytecznego.
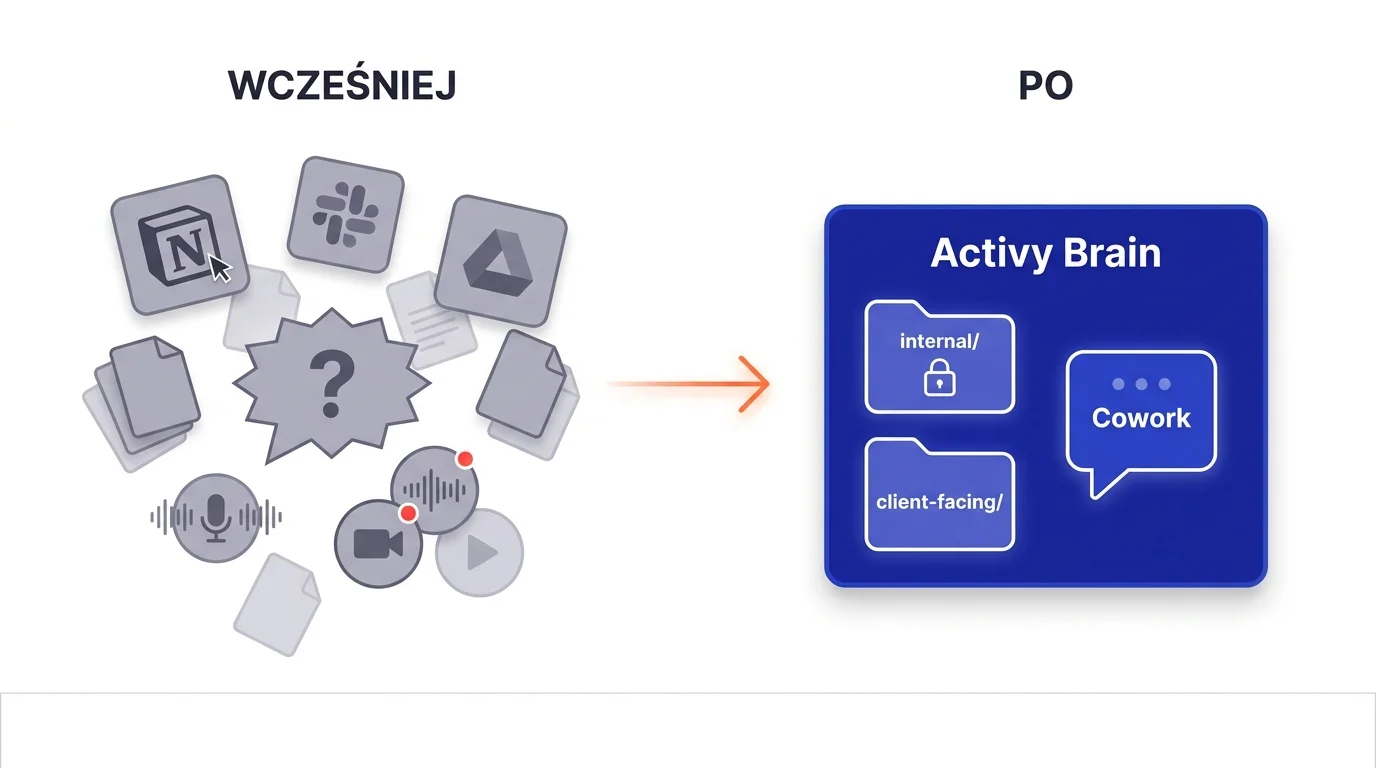
I tu wchodzi właściwy powód, dla którego w ogóle podejmowałem ten projekt. Po co to się tworzy? Chodzi o to, żeby mieć kontekst i wiedzę firmy zawsze dostępną zarówno dla ludzi, jak i dla agentów. Dla ludzi to wygodne - skraca onboarding, kończy z "spytaj Emila", redukuje frustrację. Ale dla agentów to po prostu warunek, żeby mogli robić cokolwiek użytecznego. Tylko jeśli agent ma dostęp do dobrze ustrukturyzowanego kontekstu firmy, jest w stanie pomagać pracownikom w codziennej pracy. Tylko wtedy można budować skille, które naprawdę dowożą wartość. Tylko wtedy można automatyzować pracę Customer Success, sprzedaży, marketingu - bo agent musi wiedzieć, co odpowiedzieć temu konkretnemu klientowi, w tym konkretnym momencie kontraktu, na bazie tego konkretnego scope of service.
Brain to też świetne miejsce do onboardowania nowych pracowników. Ale prawdziwa moc otwiera się dopiero, gdy do tego "mózgu firmy" dorzucisz jeszcze ustrukturyzowany kontekst klienta i jego projektu, plus skille, które potrafią orkiestrować pracę między systemami. Wtedy agent ma trzy poziomy kontekstu jednocześnie - cała firma, konkretny klient, konkretny projekt - i możesz mu zlecić odpowiadanie na maile, draftowanie decyzji, tworzenie treści, przygotowanie spotkań. Wszystko to działa, jeżeli na dole leży dobrze zrobiony brain.
Warto też dodać, że oprócz wiedzy operacyjnej i produktowej, w takim "mózgu firmy" świetnie sprawdza się osobna warstwa strategiczna. U mnie planuję dorzucić tam strategię firmy i log decyzyjny całej firmy (klientów już mamy) - bo to jest informacja, którą zespół musi mieć aktualną, żeby cokolwiek robić w spójności z kierunkiem firmy.
Każdy, kto cokolwiek robi samodzielnie, lub razem z AI, lub jak agent robi sam - musi mieć ten kontekst pod ręką.
Co istniało wcześniej i dlaczego nie wystarczało
Jeszcze ważne jest to, że nie startowałem z zera. Mieliśmy już do tej pory coś zrobione - nie idealne, ale na szybko udało się pozbierać różne treści, zrzucić to do markdownów, ułożyć tematycznie. Trzymaliśmy to w Claude Projects, czyli tym mechanizmie z Claude Chat na webie, gdzie do projektu można dodać pliki kontekstowe.
Problem zaczynał się tam, gdzie my faktycznie pracujemy. W zespole pracujemy głównie na Claude Cowork, nie na webie. Cowork można podpiąć do projectu z webu i ściągnąć z niego pliki, ale to działa jako snapshot - zrzut z konkretnego momentu. Każdy musiałby pamiętać, żeby robić go regularnie. Jak ktoś zaktualizował coś w Claude Projects na webie, to u reszty zespołu w Cowork lokalna wersja zostawała zdezaktualizowana, dopóki ktoś nie przeładował. Czyli wszystkie rzeczy, które obiecujemy sobie po wprowadzeniu KB - "zawsze aktualne, zawsze spójne, zawsze dostępne" - przy snapshotach po prostu nie byłyby prawdą.
Trzeba było wymyślić infrastrukturę, która działa natywnie w Cowork. Bo Cowork dla firmy jest najlepszym miejscem - mamy tam podpięte własne i zewnętrzne MCP, własne skille, plus Cowork w przeciwieństwie do webowego Claude Chat potrafi wykonywać za nas pracę na komputerze, nie tylko gada w czacie. To jest trochę jak Claude Code, ale dla osób nietechnicznych - i właśnie dlatego jest to dla mnie strategiczna brama, przez którą wprowadzam AI do operacji firmy.
W praktyce naturalnie przyszła myśl o folderze z plikami markdown, który zawsze ma najświeższą wersję wiedzy. Pierwsze co się rzuca w oczy, to GitHub repo. Ale tu pojawia się problem - GitHub jest super dla osób technicznych, czyli dla mnie i jednej osoby w firmie, która faktycznie współprowadzi knowledge base. Reszta zespołu nigdy w życiu nie kliknie w "Pull Request". GitHuba nie odpalą, nawet jak im powiem, że tam jest "nasza najświeższa wiedza".
Wybrałem więc rozwiązanie warstwowe. GitHub jest dla tych, którzy KB prowadzą, czyli dla mnie i jednej osoby z produktu - tam wersjonujemy, robimy commity, mamy historię, mamy review przez Pull Requesty, jak coś idzie nie tak, to wracamy do poprzedniej wersji. A reszta zespołu dostaje ten sam content przez Google Drive Desktop. Każdy ma zainstalowanego GDrive, każdy umie wskazać folder i każdy ma w Cowork projekt podpięty pod ten folder, który auto-aktualizuje się sam, bo Drive to obsługuje natywnie. A Drive z kolei aktualizuje się automatycznie z naszego GitHub repozytorium, przez prosty workflow w GitHub Actions z rclone - czyli dla zespołu wszystko dzieje się bez żadnego klikania, bez żadnego nowego narzędzia, bez większej zmiany w ich codziennej pracy.
Activy Brain to jeden z elementów mojego CAVAC
Zanim wjadę głębiej w detale, krótka uwaga kontekstowa, bo Activy Brain nie jest standalone produktem - to jest jeden z elementów większego frameworku, nad którym pracuję od kilku miesięcy. Nazwałem go CAVAC.
CAVAC w moim rozwinięciu to:
- C - Claude jako główny stack (Cowork dla zespołu, Claude Code dla mnie i power-userów)
- A - AI-native architektura danych (projektujesz schematy i procesy z myślą o agencie, nie tylko o człowieku, każdy w firmie musi adoptować AI w codziennej pracy, bez wyjątków)
- V - Vibe-coded tools firmowe (custom ERP, custom CMS, toole, customizacje core systemu - wszystko zbudowane przeze mnie z AI w ostatnich kilkunastu miesiącach)
- A - Agentic workflows zdefiniowane w skillach (deterministycznie, z evalami, nie freestyle)
- C - Cowork / Coworkerzy czyli pracownicy nietechniczni jako pierwsi obywatele tego systemu
Idea jest taka, że pracownik wykonuje pracę jednym promptem w Cowork, a pod spodem agent (czasem z subagentami) sięga do wszystkich systemów - mojego custom ERP, core platformy Activy, Fireflies (transkrypty spotkań), Gmail, HubSpot, dokumentów Office - wszystko spięte przez MCP oraz z dostępem do bazy Second Brain (strukturyzacja wiedzy i ustaleń per klient). Skille definiują, jak konkretne workflowy mają iść (bez tego agent może wymyślić, ale wtedy ryzykujesz złe wykonanie i utratę zaufania zespołu).
Activy Brain to warstwa wiedzowa, którą ten cały system odpytuje. Sam w sobie nie jest "wszechogarniającym mózgiem firmy" - jest po prostu dobrze zorganizowanym Knowledge Base, do którego sięgają zarówno ludzie z mojego zespołu, jak i agenci pracujący na ich rzecz.
Wartość Brain rośnie wykładniczo, gdy podpinasz go pod resztę elementów. Każdy element działa dobrze tylko jeśli rośnie na warstwie Brain.
Jak to faktycznie zbudowałem
Zanim opowiem o infrastrukturze, chcę zaznaczyć jedną rzecz, której z zewnątrz nie widać. Pierwsze 80% pracy to nie była infrastruktura, tylko uporządkowanie samego contentu - ciężka, ręczna, czasochłonna robota, w której Claude Opus 4.7 zarobił na siebie dziesięciokrotnie.
Sama infra to ostatnie 20% pracy. Pierwsze 80% to porządkowanie contentu.
Co konkretnie trzeba było zrobić z surową wiedzą, którą miałem w firmie:
Po pierwsze, zebrać to z różnych miejsc. Część miałem w istniejących markdownach z Claude Projects, część była rozsiana po dokumentach z agend spotkań Clients Weekly z ostatnich miesięcy, część siedziała w nagraniach spotkań jako "tribe knowledge" - czyli zasady, których nikt nie spisał, ale które wszyscy w zespole znają, bo padły kiedyś na spotkaniu. Część była w arkuszach kalkulacyjnych, część w Notion, część w wątkach Slacka. Pozbieranie tego z poszanowaniem oryginałów, bez gubienia treści - to już jest robota na cały dzień.
Po drugie, przeczyścić to merytorycznie. Wiele plików miało zdezaktualizowane fragmenty, kawałki dotyczące starych planów cenowych, których już nie sprzedajemy, instrukcje dotyczące narzędzi, których już nie używamy. Decyzje, które były aktualne pół roku temu, ale dziś już są zastąpione nowszymi. Ktoś musiał to przeczytać linijka po linijce i powiedzieć "to zostaje, to wywalamy, to się aktualizuje". Ja byłem tym kimś, ale Claude w trybie czytania-i-pytania mnie co myślę robił to ze mną na bieżąco. Bez AI to byłaby praca na kilka tygodni dla osoby z mojej firmy. Z AI zrobiliśmy to w dwa długie wieczory.
Po trzecie, ujednolicić strukturę i format. Każdy plik ma tytuł, frontmatter z tagami, jasną sekcję "po co ten plik istnieje" i wewnętrzną strukturę zgodną z konwencją całego KB. Bez tego agent ma kłopot - znajduje plik, ale nie wie, gdzie w nim jest właściwa odpowiedź. Trzeba też pilnować rzeczy, których człowiek nawet by nie zauważył - jak na przykład encoding. Część plików, które dostaliśmy z eksportów Notion, miała tak zwane "polskie krzaki" zamiast "ł", "ó", "ś". Niby czytelne dla człowieka, ale agent dostawał śmietnik. Naprawienie tego wymagało narzędzia ftfy i kilku przejść regex - drobiazg, który zżera godziny, jeśli nie wiesz, że istnieje.
Po czwarte, znaleźć i rozwiązać duplikaty oraz konflikty. Jak wszystko leży w jednym worku, okazuje się, że ta sama informacja jest w trzech miejscach, ale różni się w detalach. Która wersja jest aktualna? Która jest dla wewnętrznego użytku, a która do klienta? Czy w tym dokumencie X i tym dokumencie Y mówię to samo? Robiliśmy z Claude'em pełen pass duplikatów, oznaczanie który plik jest "master" (źródło prawdy), a który jest "derivative" (np. wersja klient-facing tłumaczona z internalu). Plus pisanie sync rules - czyli reguł, które mówią "jak edytujesz master, to derivative wymaga aktualizacji w taki-i-taki sposób".
Dalsza część artykułu jest dostępna na stronie.